

Informe Gene-Bench: ahorro de tokens por reutilización de Genes
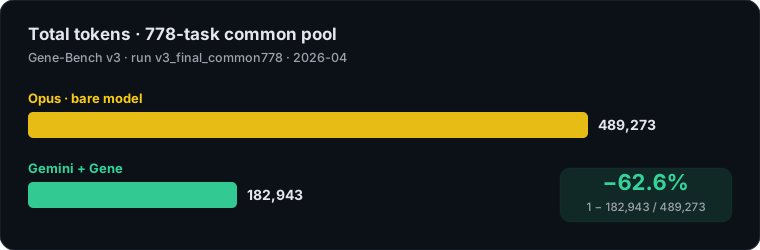
Esta página publica los resultados medidos del benchmark Gene-Bench v3: sobre un pool común de 778 tareas, Gemini + Gene ahorra un 62,6% de tokens frente al modelo Opus sin contexto. Todas las fórmulas de esta página comparten definición con las estadísticas de "Tokens ahorrados" de todo el sitio, gobernadas por la especificación savings-core (v0.3.0) y fijadas entre Hub, Desktop y evox mediante vectores dorados de conformidad.
Configuración del experimento
- Benchmark: Gene Bench v3 -- 808 tareas en 4 dominios (math_reasoning / rule_following / agent_env_synth / code_generation); la evaluación estricta
with_geneusa el pool común de 778 tareas donde ambos lados tienen activos completos - Brazos: Opus sin contexto vs Gemini + Gene evolucionado (evolved-v3, destilado de trayectorias que el propio modelo resolvió y un verificador aceptó)
- Contabilidad: tokens completos -- input + output + thoughts; run
v3_final_common778(2026-04) - Scripts de medición:
eval/compare_gene_rollout_tokens.py/eval/compare_runs.py(repositorio Gene-Bench)
Fórmula 1: tasa de ahorro global
ahorro = 1 − (tokens Gemini+Gene / tokens Opus sin contexto)
       = 1 − 182.943 / 489.273  ≈  62,6%
Fórmula 2: de dónde sale el ahorro
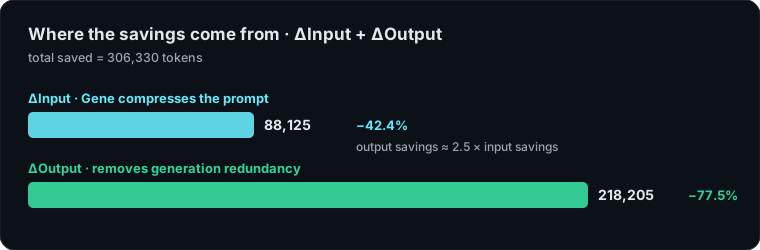
ahorro total = ΔInput (el Gene comprime el prompt) + ΔOutput (elimina redundancia de generación)
             =  88.125 (−42,4%)                    +  218.205 (−77,5%)
El ahorro del lado output es ~2,5× el del lado input -- el valor principal del Gene está en reducir la redundancia de generación, no en comprimir la entrada.
Fórmula 3: ahorro por plegado de rollouts
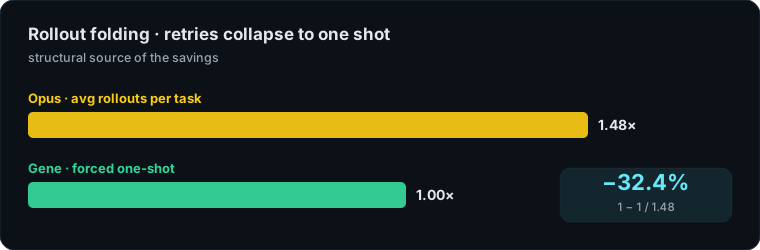
ahorro por rollouts = 1 − 1 / N(rollouts promedio) = 1 − 1/1,48 ≈ 32,4%
Opus necesitó de media 1,48 rollouts por tarea (reintento al fallar); el Gene lo pliega a un solo intento. Es la fuente estructural del ahorro: lo que desaparece no es una respuesta más corta, sino rondas enteras de reintento.
Fórmula 4: tasa de ahorro efectiva (sin fallos)
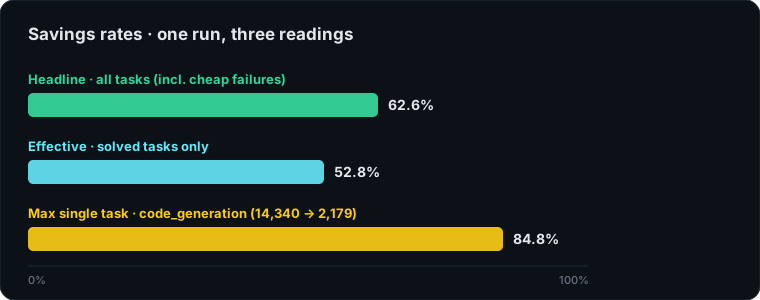
ahorro efectivo = 1 − (tokens Gemini en tareas resueltas / tokens Opus en esas tareas) = 52,8%
62,6% es la cifra de titular -- incluye los "fallos baratos" de Gemini (las respuestas erróneas tienden a generar menos). 52,8% es el ahorro cuando la tarea realmente se completa -- la lectura más conservadora y honesta.
Fórmula 5: ahorro máximo en una sola tarea
ahorro máximo = (14.340 − 2.179) / 14.340 ≈ 84,8% (caso típico de code_generation)
Intuición
ahorro = (N_rollout − 1) × coste medio por ronda + ΔT_structure (compresión estructurada del Gene)
En palabras llanas: se eliminan las N−1 rondas de reintento, y dentro de cada ronda se genera menos porque el Gene hace el prompt más preciso.
Relación con las estadísticas del sitio
| Base | Fórmula | Dónde se usa |
|---|---|---|
| Medida (R1/R2) | las cinco fórmulas de esta página | este informe; usage_ledger del Hub privado (raw/optimized/saved) |
| Estimación por coeficientes (E1) | Σ tipo de evento × coeficiente fijo | "Tokens ahorrados" en la portada y la página de Ecosistema |
Ambas bases pertenecen a la especificación savings-core (repositorio privado, v0.3.0): constantes y fórmulas quedan congeladas por vectores dorados, y las implementaciones del Hub público (Node), Hub privado (Go), Desktop (Go), evox (Rust), deck (TS) y evolver (Node) deben reproducir los mismos vectores bit a bit, con un drift-check diario. Los resultados medidos de esta página son el objetivo de calibración para una futura revisión de los coeficientes de estimación.
Advertencias
- Las cifras medidas provienen de un run concreto (
v3_final_common778); otras versiones de modelo / pools de tareas variarán. - Al citar entre tareas, preferir 52,8% (efectiva); 62,6% incluye fallos baratos y 84,8% es un techo de tarea única que no debe extrapolarse.
- Los Genes se destilan de trayectorias exitosas verificadas del propio modelo (generation_source = evolved); la evaluación usa Skills/Genes saneados sin fuga de oráculo.