

Gene-Bench 实测报告:Gene 复用的 Token 节省
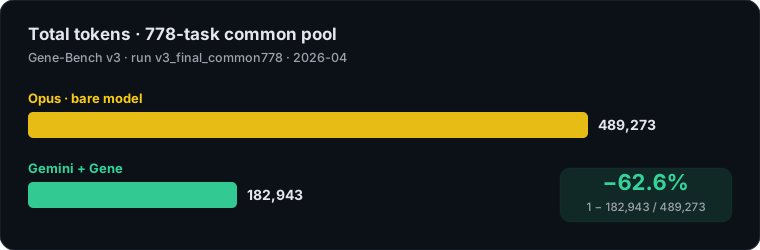
本页公示 Gene-Bench v3 基准的实测结论:在 778 题公共池上,Gemini + Gene 相对 Opus 裸模型整体节省 62.6% 的 Token。本页所有公式与全站"节省 Token"统计同源,由 savings-core 规范(v0.3.0)统一定义,跨 Hub、Desktop、evox 用金标向量做一致性校验。
实验设置
- 基准:Gene Bench v3 -- 808 题、4 个领域(math_reasoning / rule_following / agent_env_synth / code_generation),严格
with_gene评测取两侧资产齐备的 778 题公共池 - 对照:Opus 裸模型(无任何上下文资产) vs Gemini + 进化后的 Gene(evolved-v3,从模型自己解出并通过 verifier 的成功轨迹蒸馏而来)
- 口径:input + output + thoughts 全 Token 计量;run
v3_final_common778(2026-04) - 测算脚本:
eval/compare_gene_rollout_tokens.py/eval/compare_runs.py(Gene-Bench 仓库)
公式一:整体节省率
text
节省率 = 1 − (Gemini+Gene Token / Opus 裸模型 Token)
       = 1 − 182,943 / 489,273  ≈  62.6%
公式二:节省的两个来源
text
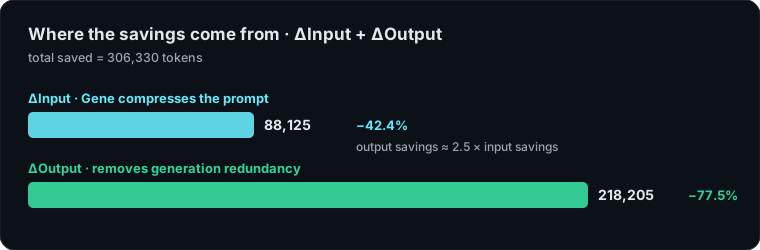
总节省 = ΔInput(Gene 压缩了 prompt) + ΔOutput(消除生成冗余)
       =  88,125 (−42.4%)          +  218,205 (−77.5%)
Output 端节省是 Input 端的约 2.5 倍 -- Gene 的主要价值在于减少模型的生成冗余,而非压缩输入。
公式三:Rollout 折叠节省
text
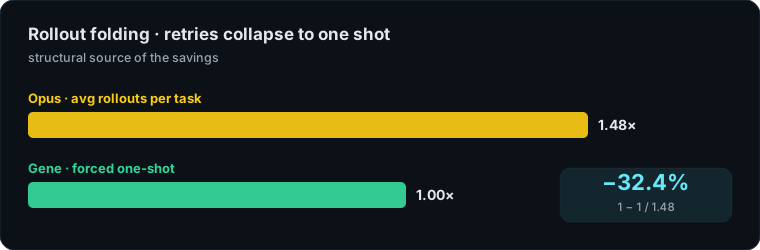
Rollout 节省 = 1 − 1 / N(平均 rollout 次数) = 1 − 1/1.48 ≈ 32.4%
Opus 平均每题需要 1.48 次 rollout(解不出就重试),Gene 把它强制折叠成 1 次。这是节省的结构性来源:省掉的不是更短的回答,而是整轮重试。
公式四:有效节省率(剔除失败题)
text
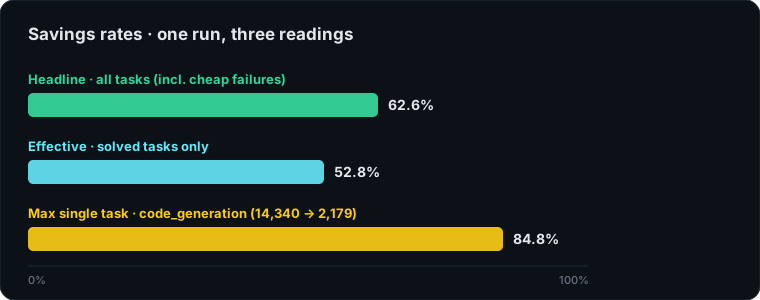
有效节省率 = 1 − (答对题的 Gemini Token / 对应题的 Opus Token) = 52.8%
62.6% 是账面数字 -- 它包含了 Gemini 答错时的"廉价失败"(答错往往生成更少)。52.8% 才是真正完成任务时的节省,这是更保守、也更诚实的口径。
公式五:单题最大节省
text
单题最大节省 = (14,340 − 2,179) / 14,340 ≈ 84.8% (code_generation 典型 case)
直觉理解
text
节省 = (N_rollout − 1) × 每轮平均成本 + ΔT_structure(Gene 结构化压缩)
白话说:省掉重试的 N−1 轮,再加上每轮里因 Gene 提示更精准而省下的生成量。
与全站统计口径的关系
| 口径 | 公式 | 用在哪 |
|---|---|---|
| 实测口径(R1/R2) | 本页五条公式 | 本报告;私有 Hub usage_ledger(raw/optimized/saved) |
| 系数估算口径(E1) | Σ 事件类型 × 固定系数 | 首页与生态系统页的"累计节省 Token" |
两套口径同属 savings-core 规范(私有仓库,spec v0.3.0):常量与公式以金标向量冻结,公开 Hub(Node)、私有 Hub(Go)、Desktop(Go)、evox(Rust)、deck(TS)、evolver(Node)各端实现逐字节复现同一组向量,每日 drift-check 防止口径漂移。本页实测结果是未来校准估算系数的依据。
注意事项
- 实测数字来自一次具体 run(
v3_final_common778),不同模型版本/任务池会有差异。 - 跨任务对比时优先引用 52.8%(有效节省率);62.6% 含廉价失败,84.8% 是单题上限,不可外推为整体。
- Gene 由模型自己解题成功的轨迹蒸馏(generation_source = evolved),评测用 sanitized Skill/Gene,不含 oracle 泄漏。