

Gene-Bench 實測報告:Gene 復用嘅 Token 節省
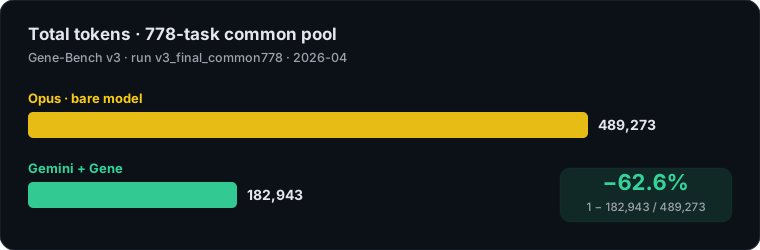
本頁公示 Gene-Bench v3 基準嘅實測結論:喺 778 題公共池上,Gemini + Gene 相對 Opus 裸模型整體節省 62.6% 嘅 Token。本頁所有公式同全站「節省 Token」統計同源,由 savings-core 規範(v0.3.0)統一定義,跨 Hub、Desktop、evox 用金標向量做一致性校驗。
實驗設置
- 基準:Gene Bench v3 -- 808 題、4 個領域(math_reasoning / rule_following / agent_env_synth / code_generation),嚴格
with_gene評測取兩側資產齊備嘅 778 題公共池 - 對照:Opus 裸模型(冇任何上下文資產) vs Gemini + 進化後嘅 Gene(evolved-v3,由模型自己解出並通過 verifier 嘅成功軌跡蒸餾而嚟)
- 口徑:input + output + thoughts 全 Token 計量;run
v3_final_common778(2026-04) - 測算腳本:
eval/compare_gene_rollout_tokens.py/eval/compare_runs.py(Gene-Bench 倉庫)
公式一:整體節省率
text
節省率 = 1 − (Gemini+Gene Token / Opus 裸模型 Token)
       = 1 − 182,943 / 489,273  ≈  62.6%
公式二:節省嘅兩個來源
text
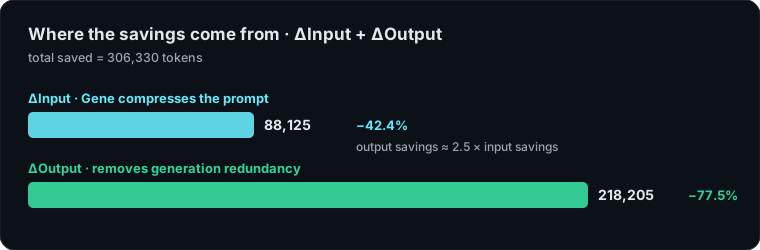
總節省 = ΔInput(Gene 壓縮咗 prompt) + ΔOutput(消除生成冗餘)
       =  88,125 (−42.4%)          +  218,205 (−77.5%)
Output 端節省係 Input 端嘅約 2.5 倍 -- Gene 嘅主要價值在於減少模型嘅生成冗餘,而唔係壓縮輸入。
公式三:Rollout 摺疊節省
text
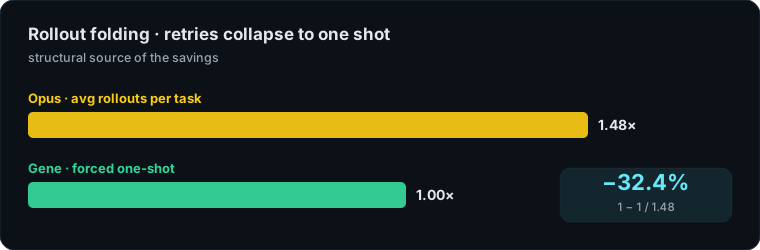
Rollout 節省 = 1 − 1 / N(平均 rollout 次數) = 1 − 1/1.48 ≈ 32.4%
Opus 平均每題需要 1.48 次 rollout(解唔出就重試),Gene 將佢強制摺疊成 1 次。呢個係節省嘅結構性來源:慳走嘅唔係更短嘅回答,而係成輪重試。
公式四:有效節省率(剔除失敗題)
text
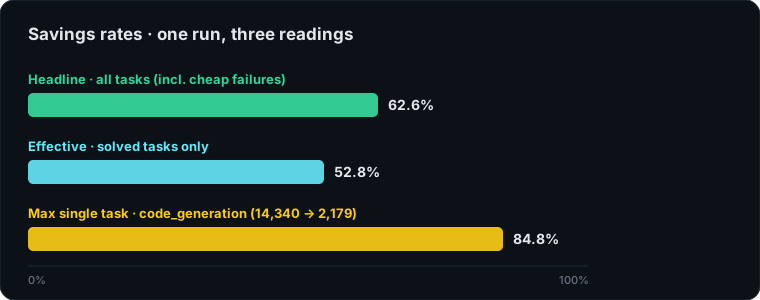
有效節省率 = 1 − (答啱題嘅 Gemini Token / 對應題嘅 Opus Token) = 52.8%
62.6% 係賬面數字 -- 佢包含咗 Gemini 答錯時嘅「廉價失敗」(答錯往往生成更少)。52.8% 先至係真正完成任務時嘅節省,係更保守、亦更誠實嘅口徑。
公式五:單題最大節省
text
單題最大節省 = (14,340 − 2,179) / 14,340 ≈ 84.8% (code_generation 典型 case)
直覺理解
text
節省 = (N_rollout − 1) × 每輪平均成本 + ΔT_structure(Gene 結構化壓縮)
白話講:慳走重試嘅 N−1 輪,再加上每輪入面因為 Gene 提示更精準而慳到嘅生成量。
同全站統計口徑嘅關係
| 口徑 | 公式 | 用喺邊 |
|---|---|---|
| 實測口徑(R1/R2) | 本頁五條公式 | 本報告;私有 Hub usage_ledger(raw/optimized/saved) |
| 系數估算口徑(E1) | Σ 事件類型 × 固定系數 | 首頁同生態系統頁嘅「累計節省 Token」 |
兩套口徑同屬 savings-core 規範(私有倉庫,spec v0.3.0):常量同公式以金標向量凍結,公開 Hub(Node)、私有 Hub(Go)、Desktop(Go)、evox(Rust)、deck(TS)、evolver(Node)各端實現逐字節復現同一組向量,每日 drift-check 防止口徑漂移。本頁實測結果係未來校準估算系數嘅依據。
注意事項
- 實測數字嚟自一次具體 run(
v3_final_common778),唔同模型版本/任務池會有差異。 - 跨任務對比時優先引用 52.8%(有效節省率);62.6% 含廉價失敗,84.8% 係單題上限,唔可以外推為整體。
- Gene 由模型自己解題成功嘅軌跡蒸餾(generation_source = evolved),評測用 sanitized Skill/Gene,唔含 oracle 洩漏。